Надпись «с автоматизированной помощью» сама по себе не говорит, станет ли приложение понятнее, быстрее или надёжнее. Краткое изложение может сэкономить время, а уверенно сформулированная ошибка — наоборот, затруднить её обнаружение. Разница зависит не только от модели, но и от устройства всей функции.
Полезная интеграция начинается с конкретной ситуации: какой шаг человек пытается выполнить, что сегодня занимает много времени или приводит к ошибкам, какой результат помог бы и что произойдёт, если предложение окажется неверным? Только после этого можно выбирать между машинным обучением, генеративной функцией и обычным правилом.
Коротко
- Начинайте с конкретной проверяемой задачи, а не с выбора модели.
- Делайте заметными неопределённость, путь данных и контроль человека.
- Сохраняйте надёжный ручной способ и тестируйте на реалистичных материалах.
От задачи к проверяемой поддержке
Автоматизированная помощь может быть полезна, когда входные данные разнообразны и система не может рассчитывать на единственный жёстко заданный ответ. Приложение может группировать заметки в свободной форме по темам, кратко излагать длинное описание, расширять поисковые запросы или предлагать значения для полей на основе документа. Во всех этих случаях автоматизация поддерживает ограниченный шаг, а у человека остаются понятная цель и возможность проверить результат.
Формулировка «помощник для всего» подходит хуже: она не позволяет проверить качество и границы функции. Продуктовой команде нужны примеры хороших, приемлемых и опасных результатов. Неполная поисковая выдача может лишь раздражать, тогда как неверная юридическая, финансовая или медицинская классификация способна привести к серьёзным последствиям. Поэтому один и тот же технический подход в зависимости от контекста требует разного интерфейса, процесса проверки, а иногда и сознательного отказа от автоматизации.
Полезный формат требований: «Система предлагает, человек решает». Он еще не определяет полную безопасность, но предотвращает важную путаницу. Предложение не является подтвержденным фактом. Если приложение должно изменить данные, должно быть понятно, что было предложено, что будет принято и как возможна корректировка.
Хорошие кандидаты: поиск, структурирование и черновики
Поиск — распространённая область применения, поскольку люди не всегда используют те же термины, что и в исходных данных. Интеллектуальный поиск может учитывать синонимы и схожие формулировки. При этом он должен показывать понятные результаты, а не выдавать один ответ за окончательный. Фильтры, сортируемые списки и обычный текстовый поиск по-прежнему полезны, особенно при поиске точных имён, чисел или дат.
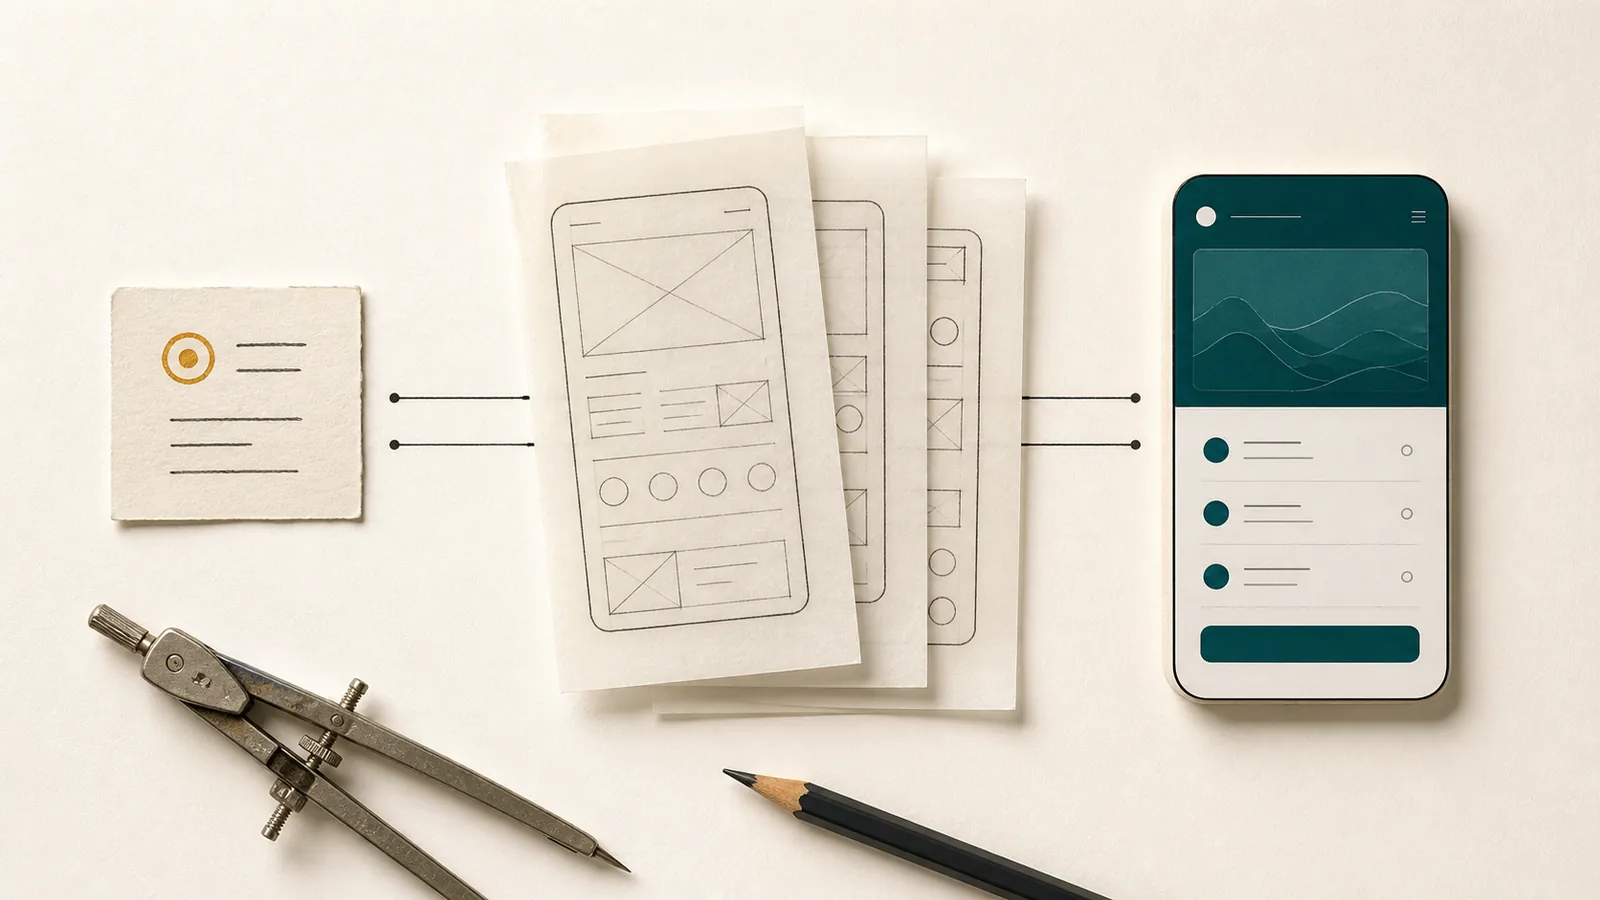
При структурировании обработка с помощью модели может предлагать категории или значения полей на основе неструктурированного текста. Рукописная заметка о ремонте, например, может содержать дату, объект и следующий шаг. Приложение вправе выделить эти значения, но перед сохранением должно показать их для проверки. Неверно распознанную дату проще исправить, пока она отображается как предложение.
Краткие изложения помогают быстрее ознакомиться с большим объёмом материала. Исходный текст должен оставаться доступным, поскольку в кратком изложении могут быть пропущены детали или искажены важные взаимосвязи. Это средство для чтения, а не замена соответствующего договора, отчёта или уведомления.
Полезными могут быть и средства для письма: черновик делового сообщения, более короткое описание или лучше структурированная заметка. Хороший интерфейс показывает, что текст создан автоматически, и упрощает редактирование. Ответственность за отправку не должна исчезать за формулировкой, которая выглядит завершённой.
Неопределённость должна быть видна в интерфейсе
Генеративные системы часто дают гладко сформулированные ответы, даже если им не хватает информации. Такая кажущаяся уверенность особенно легко вводит пользователей в заблуждение. Apple рекомендует, в частности, ясно сообщать об автоматизированной обработке, объяснять ожидания и ограничения, не создавать впечатления чрезмерной точности и предоставлять возможность проверки или обратной связи.
Простой сноски «Может содержать ошибки» редко бывает достаточно. Само взаимодействие должно соответствовать риску. Для предлагаемой категории может быть достаточно редактируемого выбора. Для некоторых извлеченных деталей контракта имеет смысл провести сравнение с источником. Если ответ основан на неопределенной или неполной информации, приложение должно запросить разъяснения, а не восполнять пробел.
Язык интерфейса также влияет на ожидания. «Распознано автоматически» звучит увереннее, чем «предложенный вариант». Выделенная основная кнопка может подтолкнуть человека принять результат без проверки. Нейтральное представление, ясное указание происхождения и простой способ отмены показывают, что контроль человека является частью задуманного процесса.
Маркировка – это больше, чем символ автоматизации
Значок с блестками стал распространенным символом вспомогательных функций. Однако без текста он не объясняет поток данных или поведение. Людям необходимо знать, что происходит, когда они активируют эту функцию: будет ли обработан только выбранный абзац или весь документ? Обработка остаётся на устройстве? Передаются ли данные во внешнюю службу? Сохранится ли результат? Можно ли отключить функцию?
Эта информация относится к точкам принятия решения. Краткое, понятное объяснение перед первым использованием более полезно, чем исключительно юридическое описание в удаленном документе. Для повторяющихся действий важные указания должны быть легко доступны, не перегружая процесс предупреждениями.
Маркировка важна и для созданного контента. Если резюме позднее появляется рядом с написанными вручную заметками, его происхождение должно оставаться понятным. Если после проверки человеком оно принято или существенно переработано, продукт может присвоить ему ясный статус. Цель не в постоянной маркировке каждой строки, а в доверии, которое создаёт прозрачное происхождение.
До интеграции проясните поток и защиту данных
Вспомогательная функция может полностью обрабатывать данные на устройстве или отправлять запросы в облачный сервис. Оба пути имеют преимущества и ограничения. Модели на устройстве могут работать в автономном режиме, сокращать время отклика и сохранять контент на устройстве. Они ограничены вычислительной мощностью, энергией, хранилищем и доступной моделью. Облачные модели могут быть более мощными или простыми в обновлении, но требуют подключения к сети и передачи данных в дополнительную инфраструктуру.
Документация Android Developers прямо описывает этот компромисс: обработка на устройстве поддерживает работу без сети и защиту данных, а облачные решения могут предоставить более крупные модели и больше вычислительной мощности. Единой архитектуры, которая всегда была бы лучшей для любого продукта, не существует. Решение зависит от чувствительности данных, конкретной задачи, требований к качеству, класса устройства, затрат и ожидаемого поведения без сети.
Перед интеграцией в облако необходимо уточнить поставщиков, цели обработки, периоды хранения, использование для обучения, регион, защиту доступа и удаление. Принцип минимизации данных остается важным: если для краткого изложения достаточно одного абзаца, в качестве меры предосторожности не следует передавать весь файл. Прямые идентификаторы могут быть удалены или заменены до того, как контент покинет устройство.
Локальная обработка тоже требует мер по защите данных. Загруженная модель занимает место, а временные файлы и журналы могут содержать конфиденциальные сведения. Должна быть предусмотрена возможность удалить входные данные и результаты в соответствии с запланированным жизненным циклом. «Локально» не означает, что можно обойтись без полной оценки безопасности.
Затраты и зависимости являются частью решения о продукте
Услуги облачных моделей часто оплачиваются по факту использования. Функция, генерирующая мало запросов в демо-версии, в повседневной жизни может стать существенно дороже. Объёмные входные данные, повторные попытки, изображения или большее количество пользователей меняют эксплуатационные расходы. Ограничения и контроль затрат не должны впоследствии непредвиденно ухудшить основной процесс.
Модели, цены, правила и интерфейсы могут меняться. Поставщик может вывести модель из эксплуатации или изменить её поведение. Поэтому продукту нужны стратегия версионирования, проверки качества и возможность заменить интеграцию. Сервис модели — не неизменный пакет, о котором после подключения можно забыть.
Надежный ручной способ – это не только удобный вариант. Он защищает основную задачу в случае проблем с сетью, сбоев в работе провайдера, исчерпания лимитов или недостаточного качества. Если заметку можно сохранить только с помощью автоматизированной системы, хотя было бы достаточно простых полей, архитектура становится излишне хрупкой. Если автоматизированная помощь ускоряет подготовку первого черновика, но информацию по-прежнему можно вводить напрямую, зависимость остаётся более управляемой.
Качество необходимо проверять в реальном контексте
Модель может показывать хорошие результаты в общих тестах, но оказаться непригодной для конкретного приложения. Профессиональная терминология, разные языки, короткие записи, фотографии низкого качества и реальные структуры документов влияют на результат. Поэтому тестовые материалы должны соответствовать предполагаемому контексту использования и включать редкие, противоречивые и намеренно проблемные случаи.
Система управления рисками NIST для решений на основе моделей описывает непрерывную работу с рисками в областях руководства, картирования, измерения и управления. Дополнительная публикация NIST о генеративных системах рассматривает, среди прочего, конфабуляции, защиту данных, целостность информации и зависимости в цепочке создания ценности. Для небольшой продуктовой команды отсюда следует практический подход: классифицировать риски до разработки, измерять последствия на подходящих примерах, назначать ответственность и продолжать наблюдение после запуска.
Метрики должны соответствовать цели продукта. При извлечении данных точность каждого поля, необходимые исправления и пропущенные значения важнее простого количества созданных предложений. Для поиска имеют значение полезные результаты и неудачные запросы. В кратких изложениях следует проверять, сохранены ли существенные утверждения и не появились ли новые, не подтверждённые источником.
Качество также меняется в зависимости от языка и содержания. Функцию нельзя выпускать только на основе аккуратных английских образцов, если пользователи работают с русскоязычными фотографиями, сокращениями или смешанными документами. Если данных недостаточно для надёжной оценки, честнее сузить область применения, чем давать общее обещание.
Когда классическая функция — лучший выбор
Многие проблемы, описанные как варианты использования автоматизированной помощи, можно решить более надежно с помощью проверенных средств. Отсортированный список не нуждается в языковой модели. Точные номера счетчиков можно легко найти с помощью обычного поиска. Для повторяющегося напоминания требуется правило, а не созданная дата. Обязательные поля, шаблоны и разумные значения по умолчанию могут ускорить ввод, не внося неопределенности.
Традиционное решение особенно эффективно, когда правила стабильны, результаты очевидны, а последствия ошибок серьезны. Его легче протестировать, зачастую он дешевле и не зависит от внешней модели. Обработка с помощью модели более уместна, когда изменчивость входных данных оправдывает дополнительные усилия, а проверяемый вариант приносит реальную пользу.
Помогает простое сравнение: можно ли полностью описать задачу чётким правилом? Тогда прежде всего следует проверить это правило. Должна ли система извлекать смысл из разнообразного неструктурированного материала? Тогда обработка с помощью модели может подойти. Может ли результат иметь серьёзные последствия и при этом трудно проверяться? Тогда правильным решением может быть отказ от автоматизации.
Ответственная вспомогательная функция может быть непримечательной
Лучшая помощь не обязана быть самой заметной функцией. Она вовремя помогает с поиском, структурой или черновиком, а затем отходит на второй план. Основная задача остаётся понятной без автоматизации, а решение — за человеком.
Ответственная автоматизация объединяет конкретную задачу, минимум данных, заметную неопределённость, проверяемый результат, надёжную ручную альтернативу и постоянный контроль качества. Без этих элементов существует лишь техническая возможность, но ещё не хорошая продуктовая функция.
Источники и дальнейшее чтение
- Apple Рекомендации по пользовательскому интерфейсу: генеративные функции – дизайн, прозрачность, ожидания и пользовательский контроль.
- Разработчики Android: модели на устройстве и облачные модели на Android – компромисс между обработкой на устройстве и облачной обработкой.
- Структура управления рисками NIST для систем на основе моделей – структура для управления рисками из надежных автоматизированных систем.
- Профиль NIST для генеративных систем – конкретные риски и меры для генеративных систем.