Het label “geautomatiseerde assistentie” zegt weinig over de vraag of een app duidelijker, sneller of betrouwbaarder wordt. Een samenvatting kan tijdrovend voorbereidend werk verkorten; een overtuigend geformuleerde maar onjuiste classificatie kan een fout juist moeilijker herkenbaar maken. Het verschil zit niet alleen in het model, maar in het ontwerp van de volledige functie.
Een zinvolle integratie begint daarom bij een concrete situatie. Welke stap probeert iemand te voltooien? Wat gaat nu traag of is foutgevoelig? Welk resultaat zou helpen en wat gebeurt er als de suggestie onjuist is? Pas daarna kan een team bepalen of machine learning, een generatieve functie of een conventionele regel de juiste techniek is.
In het kort
- Begin met een concrete, toetsbare taak en niet met de keuze voor een model.
- Houd onzekerheid, gegevensstromen en menselijke controle zichtbaar in de interface.
- Behoud een betrouwbare handmatige route en test met realistische inhoud.
Van een concrete taak naar controleerbare ondersteuning
Geautomatiseerde assistentie kan nuttig zijn wanneer invoer veelzijdig is en een systeem niet één strikt antwoord kan verwachten. Een app kan vrije notities per onderwerp groeperen, een lange beschrijving samenvatten, zoektermen uitbreiden of op basis van een document waarden voor velden voorstellen. In al die gevallen ondersteunt ze een beperkte stap. De gebruiker houdt een begrijpelijk doel en kan het resultaat controleren.
De formulering “een assistent voor alles” is minder geschikt, omdat daarmee kwaliteit en grenzen niet toetsbaar zijn. Een productteam heeft voorbeelden nodig van goede, aanvaardbare en gevaarlijke resultaten. Bij een zoekopdracht kan een onvolledig resultaat vervelend zijn. Bij een juridische, financiële of medische classificatie kan een onjuist antwoord ernstige gevolgen hebben. Afhankelijk van de context vraagt dezelfde techniek om een andere interface, een ander beoordelingsproces of zelfs een bewuste keuze om niet te automatiseren.
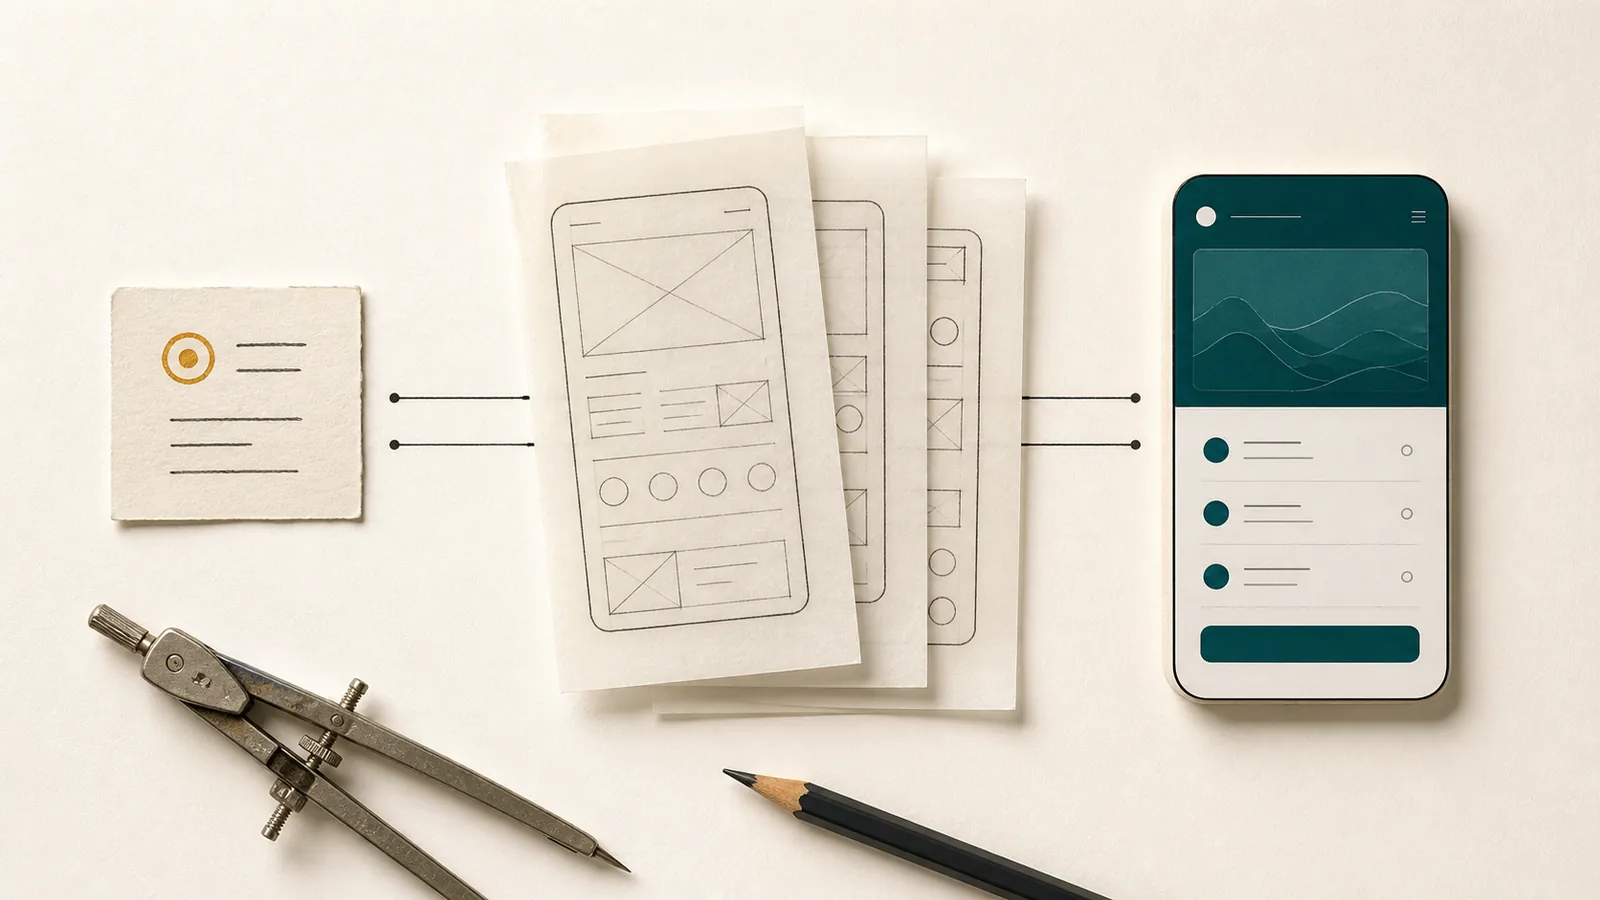
Een bruikbaar formaat voor een eis is: “Het systeem stelt voor; de mens beslist.” Daarmee is nog niet de volledige veiligheid geregeld, maar wel een belangrijke verwarring voorkomen. Een voorstel is geen bevestigd feit. Wanneer de app gegevens kan wijzigen, moet duidelijk zijn wat is voorgesteld, wat wordt overgenomen en hoe een correctie mogelijk is.
Goede toepassingen: zoeken, structureren en concepten
Zoeken is een veelvoorkomende toepassing, omdat mensen niet altijd dezelfde termen gebruiken als in de onderliggende gegevens. Een intelligente zoekfunctie kan synoniemen en vergelijkbare formuleringen meenemen. Toch moet ze herkenbare resultaten tonen en niet doen alsof er één definitief antwoord bestaat. Filters, sorteerbare lijsten en een klassieke tekstzoekfunctie blijven waardevol, vooral bij het zoeken naar exacte namen, nummers of datums.
Bij het structureren kan modelondersteunde verwerking uit onregelmatige tekst voorstellen voor categorieën of velden afleiden. Een handgeschreven notitie over een reparatie kan bijvoorbeeld een datum, een object en een volgende stap bevatten. De app mag die waarden markeren, maar moet ze vóór het opslaan ter controle tonen. Een verkeerd gelezen datum is gemakkelijker te corrigeren zolang die nog als zichtbaar voorstel wordt gepresenteerd.
Samenvattingen helpen wanneer iemand lange inhoud sneller wil doornemen. De oorspronkelijke bron moet toegankelijk blijven. Een samenvatting kan details weglaten of verbanden verkeerd wegen. Ze is een leeshulpmiddel, geen vervanging voor het relevante contract, rapport of besluit.
Ook schrijfhulp kan nuttig zijn: een concept voor een zakelijke boodschap, een kortere beschrijving of een beter gestructureerde notitie. Een goed ontwerp maakt duidelijk dat de tekst is gegenereerd en vereenvoudigt het bewerken. De verantwoordelijkheid voor het verzenden mag niet verdwijnen achter een schijnbaar afgeronde formulering.
Onzekerheid hoort in de interface
Generatieve systemen produceren vaak vloeiende antwoorden, ook wanneer informatie ontbreekt. Juist die schijnbare zekerheid kan gebruikers misleiden. Apple adviseert voor generatieve functies onder meer om duidelijk te melden wanneer geautomatiseerde verwerking wordt gebruikt, verwachtingen en beperkingen uit te leggen, geen overdreven nauwkeurigheid te suggereren en een mogelijkheid voor controle of feedback te bieden.
Een voetnoot met “Kan fouten bevatten” is zelden voldoende. De interactie zelf moet bij het risico passen. Voor een voorgestelde categorie kan een bewerkbare selectie volstaan. Bij meerdere uit een contract afgeleide gegevens is een vergelijking met de bron zinvol. Als een antwoord op onzekere of onvolledige informatie berust, moet de app om verduidelijking vragen in plaats van de leemte te verhullen.
Ook de taal van de interface beïnvloedt verwachtingen. “Automatisch herkend” klinkt stelliger dan “Voorstel”. Een sterk benadrukte primaire knop kan mensen ertoe aanzetten een resultaat zonder controle over te nemen. Een neutrale presentatie, duidelijke herkomst en een eenvoudige weg terug maken zichtbaar dat menselijke controle onderdeel van het bedoelde proces is.
Alleen een automatiseringssymbool is niet genoeg
Een fonkelpictogram is een gangbaar symbool voor ondersteunende functies geworden. Zonder tekst legt het echter noch de gegevensstroom, noch het gedrag uit. Mensen moeten weten wat er bij activering gebeurt: wordt alleen de geselecteerde alinea verwerkt of het hele document? Blijft de verwerking op het apparaat? Worden gegevens naar een externe dienst verstuurd? Wordt het resultaat opgeslagen? Kan de functie worden uitgeschakeld?
Die informatie hoort op de beslismomenten te staan. Een korte, begrijpelijke uitleg vóór het eerste gebruik is nuttiger dan uitsluitend juridische uitleg in een afzonderlijk document. Bij terugkerende handelingen moeten essentiële aanwijzingen gemakkelijk te vinden blijven zonder elk proces met waarschuwingen te overladen.
De aanduiding geldt ook voor gegenereerde inhoud. Als een samenvatting later naast handmatig geschreven notities staat, moet de herkomst herkenbaar blijven. Is de tekst na menselijke controle overgenomen of ingrijpend bewerkt, dan kan het product een duidelijke status tonen. Het doel is niet om elke regel permanent te markeren, maar om vertrouwen mogelijk te maken door transparante herkomst.
Gegevensstromen en gegevensbescherming vóór de integratie verduidelijken
Een ondersteunende functie kan gegevens volledig op het apparaat verwerken of verzoeken naar een clouddienst sturen. Beide opties hebben voordelen en beperkingen. Modellen op het apparaat kunnen offline werken, reactietijden verkorten en inhoud op het toestel houden. Hun grenzen worden bepaald door rekenkracht, energie, opslag en het beschikbare model. Cloudmodellen kunnen krachtiger of eenvoudiger te actualiseren zijn, maar vereisen een netwerkverbinding en sturen gegevens naar aanvullende infrastructuur.
Android Developers beschrijft die afweging expliciet: verwerking op het apparaat versterkt onder meer offlinegebruik en gegevensbescherming, terwijl cloudoplossingen grotere modellen en meer rekenkracht mogelijk kunnen maken. Daaruit volgt geen universeel winnende architectuur. Doorslaggevend zijn de gevoeligheid van de gegevens, de taak, de kwaliteitseisen, het type apparaat, de kosten en het verwachte gedrag zonder netwerk.
Vóór een cloudintegratie moeten de aanbieders, verwerkingsdoeleinden, bewaartermijnen, het gebruik voor training, de regio, toegangsbeveiliging en verwijdering duidelijk zijn. Het beginsel van gegevensminimalisatie blijft belangrijk: als één alinea voor een samenvatting volstaat, mag niet uit voorzorg het volledige bestand worden verstuurd. Directe identificatiegegevens kunnen worden verwijderd of vervangen voordat de inhoud het apparaat verlaat.
Ook lokale verwerking vraagt om maatregelen voor gegevensbescherming. Een gedownload model neemt opslagruimte in. Tijdelijke bestanden en logboeken kunnen gevoelige inhoud bevatten. Invoer en resultaten moeten volgens de bedoelde levenscyclus kunnen worden verwijderd. “Lokaal” is geen vrijbrief om een volledige beveiligingsbeoordeling over te slaan.
Kosten en afhankelijkheden horen bij de productbeslissing
Clouddiensten voor modellen worden vaak op basis van gebruik afgerekend. Een functie die in een demonstratie maar enkele verzoeken uitvoert, kan in dagelijks gebruik aanzienlijk duurder worden. Lange invoer, herhaalde pogingen, afbeeldingen of meer gebruikers veranderen de bedrijfskosten. Limieten en kostenbeheersing mogen het kernproces later niet onverwacht verslechteren.
Modellen, prijzen, beleidsregels en interfaces kunnen veranderen. Een aanbieder kan een model uitfaseren of het gedrag ervan aanpassen. Het product heeft daarom een strategie nodig voor versies, kwaliteitscontroles en een mogelijke overstap. Een modeldienst is geen onveranderlijk pakket dat na de integratie altijd hetzelfde blijft.
Een betrouwbare handmatige route is niet alleen een gemaksoptie. Ze beschermt de kerntaak bij netwerkproblemen, storingen bij de aanbieder, opgebruikte limieten of onvoldoende kwaliteit. Als een notitie alleen met geautomatiseerde assistentie kan worden opgeslagen terwijl eenvoudige velden zouden volstaan, is de architectuur onnodig kwetsbaar. Versnelt de assistentie een eerste concept maar blijft directe invoer mogelijk, dan is de afhankelijkheid beter beheersbaar.
Kwaliteit moet in de werkelijke context worden getoetst
Een model kan goed presteren in algemene benchmarks en toch onbruikbaar zijn in een specifieke app. Vakbegrippen, talen, korte invoer, slechte foto’s en echte documentstructuren veranderen het resultaat. Tests moeten daarom uit de bedoelde gebruikscontext komen en ook zeldzame, tegenstrijdige of bewust problematische gevallen bevatten.
Het NIST-raamwerk voor risicobeheer van modelgebaseerde systemen beschrijft een voortdurende omgang met risico’s op het gebied van governance, contextualisering, meting en beheer. De aanvullende NIST-publicatie over generatieve systemen behandelt onder meer verzonnen informatie, gegevensbescherming, informatie-integriteit en afhankelijkheden in de waardeketen. Een klein productteam kan daaruit een praktische houding afleiden: risico’s vóór de ontwikkeling indelen, effecten met geschikte voorbeelden meten, verantwoordelijkheden vastleggen en het gedrag na de introductie blijven volgen.
Meetwaarden moeten bij het productdoel passen. Bij extractie zijn nauwkeurigheid per veld, noodzakelijke correcties en gemiste waarden informatiever dan alleen het aantal gegenereerde voorstellen. Bij zoeken tellen nuttige resultaten en mislukte zoekopdrachten. Bij samenvattingen moet worden gecontroleerd of essentiële uitspraken behouden blijven en er geen nieuwe beweringen ontstaan.
Kwaliteit kan ook per taal en inhoud verschillen. Een functie mag niet alleen op basis van nette Engelse voorbeeldsets worden vrijgegeven als mensen foto’s, afkortingen of gemengde documenten in andere talen gebruiken. Waar onvoldoende gegevens voor een betrouwbare beoordeling bestaan, is een kleiner toepassingsgebied eerlijker dan een algemene belofte.
Wanneer een klassieke functie de betere keuze is
Veel problemen die als toepassingen voor geautomatiseerde assistentie worden beschreven, kunnen betrouwbaarder met beproefde middelen worden opgelost. Een gesorteerde lijst heeft geen taalmodel nodig. Exacte meternummers zijn met een normale zoekfunctie gemakkelijk te vinden. Een terugkerende herinnering vraagt om een regel, niet om een gegenereerde datum. Verplichte velden, sjablonen en passende standaardwaarden kunnen invoer versnellen zonder onzekerheid toe te voegen.
Een conventionele oplossing is vooral sterk wanneer regels stabiel zijn, resultaten duidelijk en de gevolgen van fouten ernstig. Ze is eenvoudiger te testen, vaak goedkoper en onafhankelijk van een extern model. Modelondersteunde verwerking past beter wanneer de variatie in de invoer de extra inspanning rechtvaardigt en een controleerbaar voorstel werkelijk voordeel biedt.
Een eenvoudige vergelijking helpt: kan de taak volledig als een duidelijke regel worden beschreven? Toets die regel dan eerst. Moet het systeem betekenis uit uiteenlopend, ongestructureerd materiaal halen? Dan kan modelondersteunde verwerking geschikt zijn. Heeft het resultaat grote gevolgen en is het moeilijk te controleren? Dan kan niet automatiseren de juiste keuze zijn.
Verantwoorde ondersteuning mag onopvallend zijn
De beste ondersteuning hoeft niet de opvallendste functie van een app te zijn. Ze helpt op het juiste moment bij zoeken, structureren of een eerste concept en verdwijnt daarna weer naar de achtergrond. Het kernproces blijft begrijpelijk wanneer automatisering niet beschikbaar is en de beslissing blijft bij de gebruiker.
Verantwoorde automatisering verbindt daarom een concrete taak met minimale gegevens, zichtbare onzekerheid, een controleerbaar resultaat, een betrouwbare handmatige route en voortdurende kwaliteitsbewaking. Zonder die elementen is er alleen een technische mogelijkheid, nog geen goede productfunctie.
Bronnen en verder lezen
- Apple Human Interface Guidelines: Generative features – ontwerp, transparantie, verwachtingen en gebruikerscontrole.
- Android Developers: On-device and cloud models on Android – afwegingen tussen verwerking op het apparaat en in de cloud.
- NIST Risk Management Framework voor modelgebaseerde systemen – een raamwerk voor het beheren van risico’s van betrouwbare geautomatiseerde systemen.
- NIST-profiel voor generatieve systemen – specifieke risico’s en maatregelen voor generatieve systemen.