La expresión «asistencia automatizada» no basta para saber si una aplicación será más clara, rápida o fiable. Un resumen puede ahorrar trabajo repetitivo; una clasificación errónea presentada con seguridad puede hacer que el fallo sea aún más difícil de detectar. La diferencia no depende solo del modelo, sino del diseño de toda la función.
Por eso, una integración útil empieza con una situación concreta. ¿Qué paso intenta completar la persona? ¿Qué resulta lento o propenso a errores hoy? ¿Qué resultado ayudaría y qué ocurriría si la sugerencia fuera incorrecta? Solo entonces puede el equipo decidir si la técnica adecuada es el aprendizaje automático, una función generativa o una regla convencional.
En pocas palabras
- Empezar por una tarea específica y verificable, no por la elección de un modelo.
- Mantener visibles en la interfaz la incertidumbre, el recorrido de los datos y el control humano.
- Conservar una alternativa manual fiable y probar con contenido realista.
De una tarea concreta a una ayuda verificable
La asistencia automatizada puede resultar útil cuando los datos de entrada son variados y el sistema no puede esperar una única respuesta rígida. Una aplicación puede agrupar notas libres por temas, resumir una descripción larga, ampliar términos de búsqueda o sugerir valores para los campos de un documento. En todos estos casos apoya un paso limitado. La persona conserva un objetivo comprensible y puede comprobar el resultado.
La fórmula «un asistente para todo» es menos útil porque no permite probar la calidad ni los límites. Un equipo de producto necesita, en cambio, ejemplos de resultados buenos, aceptables y peligrosos. En una búsqueda, un resultado incompleto puede ser molesto. En una clasificación jurídica, financiera o sanitaria, una respuesta errónea puede tener consecuencias importantes. Según el contexto, el mismo planteamiento técnico exige otra interfaz, otro proceso de revisión o incluso la decisión consciente de no automatizar.
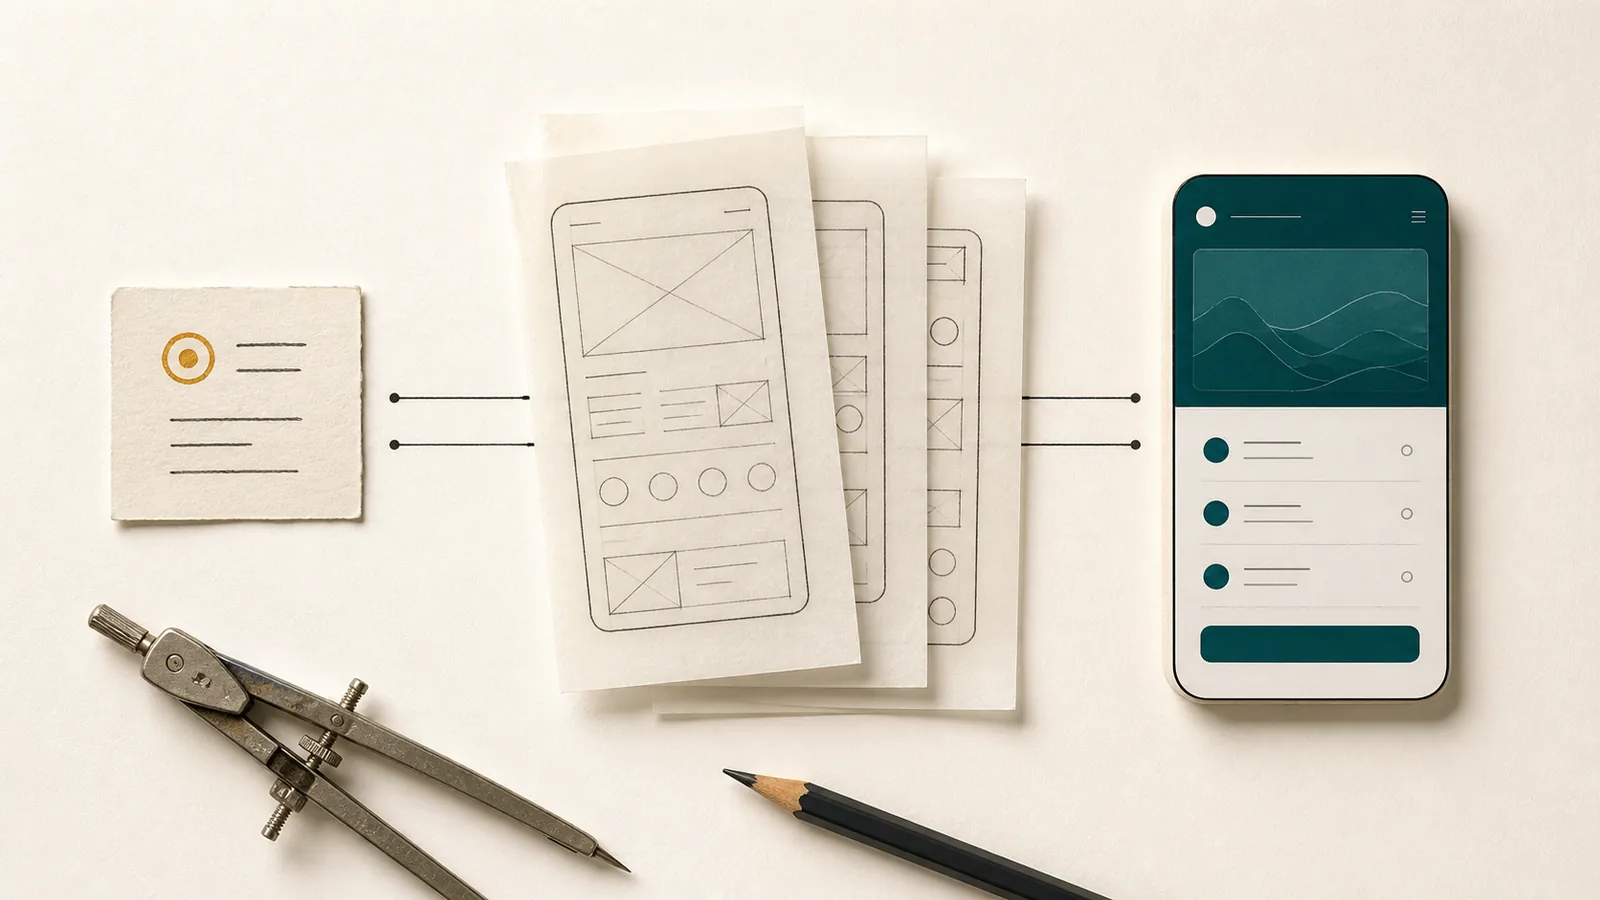
Un formato de requisito útil es: «El sistema sugiere; la persona decide». Aún no define toda la seguridad necesaria, pero evita una confusión importante: una propuesta no es un hecho confirmado. Cuando la aplicación puede cambiar datos, debe quedar claro qué se ha sugerido, qué se ha aceptado y cómo se corrige un error.
Buenos casos de uso: búsqueda, estructuración y borradores
La búsqueda es un ámbito habitual porque las personas no siempre emplean los mismos términos que aparecen en los datos. Una búsqueda inteligente puede tener en cuenta sinónimos o formulaciones parecidas. Aun así, debe mostrar resultados reconocibles y no fingir que existe una única respuesta final. Los filtros, las listas ordenables y una búsqueda de texto clásica siguen siendo valiosos, sobre todo cuando se buscan nombres, números o fechas exactos.
Al estructurar información, el procesamiento asistido por modelos puede sugerir categorías o campos a partir de texto irregular. Una nota manuscrita sobre una reparación podría contener, por ejemplo, una fecha, un objeto y el siguiente paso. La aplicación puede destacar esos valores, pero debería presentarlos para revisión antes de guardarlos. Una fecha mal leída es más fácil de corregir mientras todavía aparece como sugerencia.
Los resúmenes ayudan cuando una persona quiere revisar contenido extenso con mayor rapidez. La fuente original debe seguir accesible. Un resumen puede omitir detalles o ponderar mal las relaciones; es una ayuda para la lectura, no un sustituto del contrato, informe o aviso correspondiente.
Las ayudas para redactar también pueden ser útiles: un borrador de mensaje objetivo, una descripción más breve o una nota mejor estructurada. Un buen diseño indica que el texto se ha generado y facilita su edición. La responsabilidad del envío no debe desaparecer detrás de una formulación que parece terminada.
La incertidumbre debe estar visible en la interfaz
Los sistemas generativos producen a menudo respuestas fluidas incluso cuando les falta información. Precisamente esa aparente seguridad puede engañar a las personas. Para las funciones generativas, Apple recomienda, entre otras cosas, comunicar con claridad cuándo existe procesamiento automatizado, explicar expectativas y límites, evitar una apariencia de precisión excesiva y ofrecer una forma de comprobar el resultado o enviar comentarios.
Una simple nota al pie que diga «Puede contener errores» rara vez es suficiente. La propia interacción debe corresponder al riesgo. Para una categoría sugerida puede bastar una selección editable. Para varios datos extraídos de un contrato conviene compararlos con la fuente. Si una respuesta se basa en información incierta o incompleta, la aplicación debe pedir aclaraciones en lugar de ocultar la laguna.
El lenguaje de la interfaz también influye en las expectativas. «Reconocido automáticamente» suena más definitivo que «Sugerencia». Un botón principal muy destacado puede empujar a aceptar el resultado sin revisarlo. Una presentación neutra, un origen claro y una forma sencilla de volver atrás muestran que el control humano forma parte del proceso previsto.
Un símbolo de automatización no es suficiente
El icono de destello se ha convertido en un símbolo habitual de las funciones asistidas. Sin texto, sin embargo, no explica el flujo de datos ni el comportamiento. Las personas deben saber qué ocurre al activarlo: ¿se procesa solo el párrafo seleccionado o el documento completo? ¿El procesamiento permanece en el dispositivo? ¿Se envían datos a un servicio externo? ¿Se guarda el resultado? ¿Puede desactivarse la función?
Esta información debe aparecer en los puntos de decisión. Una explicación breve y comprensible antes del primer uso es más útil que una descripción exclusivamente jurídica en un documento remoto. En acciones recurrentes, la orientación esencial debe seguir siendo fácil de encontrar sin sobrecargar cada proceso con advertencias.
El etiquetado también se aplica al contenido generado. Si un resumen aparece más tarde junto a notas escritas a mano, su origen debe seguir siendo reconocible. Si se ha aceptado tras una revisión humana o se ha editado de forma sustancial, el producto puede mostrar un estado claro. El objetivo no es marcar cada línea para siempre, sino generar confianza mediante una procedencia transparente.
Aclarar el recorrido y la protección de los datos antes de integrar
Una función asistida puede procesar los datos por completo en el dispositivo o enviar solicitudes a un servicio en la nube. Ambas opciones tienen ventajas y limitaciones. Los modelos locales pueden funcionar sin conexión, acortar el tiempo de respuesta y mantener el contenido en el dispositivo. Están limitados por la capacidad de cálculo, la energía, el almacenamiento y los modelos disponibles. Los modelos en la nube pueden ser más potentes o fáciles de actualizar, pero necesitan red y transfieren los datos a una infraestructura adicional.
Android Developers describe expresamente este equilibrio: el procesamiento en el dispositivo refuerza, entre otras cosas, el uso sin conexión y la protección de datos, mientras que las soluciones en la nube pueden permitir modelos mayores y más capacidad de cálculo. De ello no se deriva una arquitectura ganadora para todos los productos. Son decisivos la sensibilidad de los datos, la tarea, la calidad requerida, el tipo de dispositivo, los costes y el comportamiento esperado sin red.
Antes de integrar un servicio en la nube hay que aclarar los proveedores, los fines del tratamiento, los plazos de conservación, el uso para entrenamiento, la región, la protección del acceso y la eliminación. El principio de minimización de datos sigue siendo importante: si un párrafo basta para un resumen, no debe transferirse preventivamente el archivo completo. Los identificadores directos pueden eliminarse o sustituirse antes de que el contenido salga del dispositivo.
El procesamiento local también requiere medidas de protección. Un modelo descargado ocupa almacenamiento. Los archivos temporales y los registros técnicos pueden contener información sensible. Las entradas y los resultados deben eliminarse según el ciclo de vida previsto. «Local» no es un atajo que sustituya una evaluación completa de seguridad.
Los costes y las dependencias forman parte de la decisión de producto
Los servicios de modelos en la nube suelen facturarse según el uso. Una función que genera pocas solicitudes en una demostración puede resultar mucho más cara en el día a día. Las entradas largas, los intentos repetidos, las imágenes o un mayor número de usuarios cambian los costes operativos. Los límites y controles de coste no deben empeorar más adelante el proceso principal de forma imprevista.
Los modelos, precios, políticas e interfaces pueden cambiar. Un proveedor puede retirar un modelo o actualizar su comportamiento. El producto necesita, por tanto, una estrategia de versiones, controles de calidad y un posible cambio de proveedor. Un servicio basado en modelos no es un paquete inmutable que permanece igual después de integrarlo.
Una vía manual fiable no es solo una opción cómoda. Protege la tarea principal ante problemas de red, interrupciones del proveedor, límites agotados o calidad insuficiente. Si una nota solo puede guardarse con asistencia automatizada, aunque bastarían campos sencillos, la arquitectura es innecesariamente frágil. Si la asistencia acelera el primer borrador pero sigue siendo posible introducir los datos directamente, la dependencia es más controlable.
La calidad debe comprobarse en el contexto real
Un modelo puede funcionar bien en pruebas de referencia generales y, aun así, no servir en una aplicación concreta. Los términos técnicos, los idiomas, las entradas breves, las fotografías deficientes y las estructuras reales de documentos alteran el resultado. Las pruebas deben partir, por tanto, del contexto de uso previsto e incluir también casos raros, contradictorios o problemáticos de forma intencionada.
El marco de gestión de riesgos del NIST para sistemas basados en modelos describe un tratamiento continuo de los riesgos en las áreas de gobierno, contextualización, medición y gestión. La publicación complementaria del NIST sobre sistemas generativos aborda, entre otras cosas, las confabulaciones, la protección de datos, la integridad de la información y las dependencias en la cadena de valor. Un equipo pequeño puede extraer una práctica concreta: clasificar los riesgos antes del desarrollo, medir los efectos con casos adecuados, definir responsabilidades y seguir observando el comportamiento después del lanzamiento.
Las métricas deben corresponder al objetivo del producto. En una extracción, la precisión de cada campo, las correcciones necesarias y los valores omitidos son más útiles que el mero número de sugerencias. En una búsqueda cuentan los resultados útiles y las consultas sin éxito. En los resúmenes debe comprobarse que se conservan las afirmaciones esenciales y que no aparecen otras nuevas.
La calidad también puede variar según el idioma y el contenido. Una función no debe lanzarse solo con muestras limpias en inglés si las personas usan fotografías, abreviaturas o documentos mixtos en otros idiomas. Cuando no hay datos suficientes para una evaluación fiable, un ámbito de uso más reducido es más honesto que una promesa general.
Cuando una función convencional es la mejor opción
Muchos problemas descritos como casos para la asistencia automatizada pueden resolverse de forma más fiable con medios probados. Una lista ordenada no necesita un modelo lingüístico. Los números exactos de un contador se encuentran fácilmente con una búsqueda normal. Un recordatorio recurrente requiere una regla, no una fecha generada. Los campos obligatorios, las plantillas y unos valores predeterminados adecuados pueden acelerar la entrada sin añadir incertidumbre.
Una solución convencional resulta especialmente sólida cuando las reglas son estables, los resultados claros y las consecuencias de los errores graves. Es más fácil de probar, a menudo más barata e independiente de un modelo externo. El procesamiento asistido por modelos encaja mejor cuando la variabilidad de la entrada justifica el esfuerzo adicional y una propuesta verificable aporta una ventaja real.
Ayuda una comparación sencilla: ¿la tarea puede describirse por completo mediante una regla clara? Entonces conviene probar primero esa regla. ¿El sistema debe extraer significado de material variado y no estructurado? En ese caso, el procesamiento asistido por modelos puede ser adecuado. ¿El resultado tiene consecuencias importantes y es difícil de verificar? Entonces la decisión correcta también puede ser no automatizar.
Una asistencia responsable puede ser discreta
La mejor asistencia no tiene que ser la función más vistosa de la aplicación. Puede ayudar en el momento adecuado con una búsqueda, una estructura o un primer borrador y después pasar a segundo plano. El proceso principal sigue siendo comprensible cuando la automatización no está disponible, y la decisión permanece en manos de la persona.
Una automatización responsable vincula una tarea concreta con un mínimo de datos, incertidumbre visible, un resultado verificable, una alternativa manual fiable y un control continuo de la calidad. Sin estos elementos solo existe una posibilidad técnica, todavía no una buena función de producto.
Fuentes y más información
- Apple Human Interface Guidelines: Generative features – diseño, transparencia, expectativas y control de las personas.
- Android Developers: On-device and cloud models on Android – equilibrio entre el procesamiento en el dispositivo y en la nube.
- Marco del NIST para los riesgos de sistemas basados en modelos – un marco para gestionar los riesgos de sistemas automatizados fiables.
- Perfil del NIST para sistemas generativos – riesgos y medidas específicos para sistemas generativos.