Označení „s automatizovanou pomocí“ samo neříká, zda bude aplikace srozumitelnější, rychlejší nebo spolehlivější. Shrnutí může ušetřit práci, ale sebejistě formulovaná chyba se naopak hůře odhaluje. Rozdíl není jen v modelu, nýbrž v návrhu celé funkce.
Užitečná integrace proto začíná konkrétní situací: jaký krok se člověk snaží dokončit, co je dnes pomalé nebo náchylné k chybám a jaké následky by měl nesprávný návrh? Teprve potom lze rozhodnout, zda je vhodný model, generativní funkce nebo běžné pravidlo.
Stručně
- Začněte konkrétním a ověřitelným úkolem, nikoli výběrem modelu.
- Udržujte nejistotu, tok dat a lidskou kontrolu viditelné.
- Zachovejte spolehlivý ruční postup a testujte s reálným obsahem.
Od úkolu k ověřitelné podpoře
Automatizovaná pomoc může být užitečná tam, kde mají vstupy mnoho podob a systém nemůže očekávat jedinou pevně danou odpověď. Aplikace může seskupovat volně psané poznámky podle témat, shrnout dlouhý popis, rozšířit vyhledávací dotaz nebo z dokumentu navrhnout hodnoty jednotlivých polí. Ve všech případech podporuje jen vymezený krok; člověk má stále jasný cíl a výsledek může zkontrolovat.
Méně vhodná je formulace „asistent pro všechno“. Neumožňuje testovat kvalitu nebo limity. Místo toho potřebuje produktový tým příklady dobrých, přijatelných a nebezpečných výsledků. Při hledání může vadit neúplný výsledek. V případě právní, finanční nebo zdravotní klasifikace může mít špatná odpověď značné důsledky. Stejný technický přístup vyžaduje odlišné rozhraní, proces kontroly a možná i vědomé rozhodnutí proti automatizaci v závislosti na kontextu.
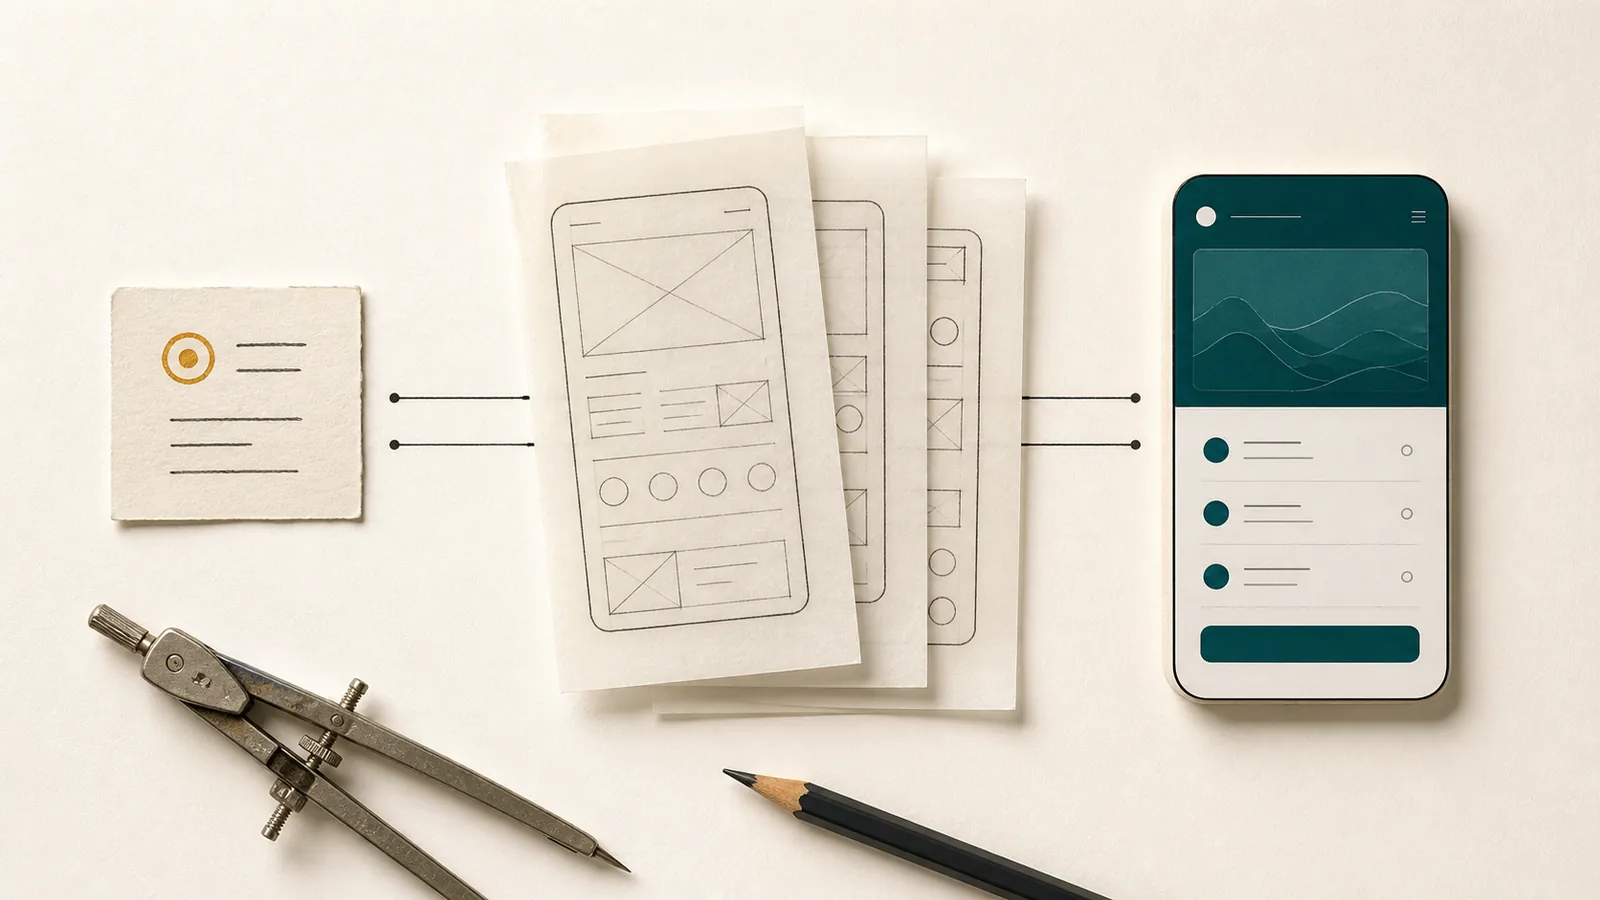
Užitečný formát požadavku je: “Systém navrhuje, člověk rozhoduje.” Ještě nedefinuje úplnou bezpečnost, ale zabraňuje důležitým zmatkům. Návrh není potvrzenou skutečností. Pokud má aplikace změnit data, musí být jasné, co bylo navrženo, co bude přijato a jak lze výsledek opravit.
Dobří kandidáti: vyhledávání, strukturování a návrhy
Vyhledávání je běžnou oblastí použití, protože lidé ne vždy používají stejné výrazy jako podkladová data. Inteligentní vyhledávání může zohlednit synonyma nebo podobné formulace. Přesto by mělo zobrazovat srozumitelné výsledky a nepředstírat, že existuje jediná konečná odpověď. Cenné zůstávají filtry, tříditelné seznamy a klasické textové vyhledávání, zejména při hledání přesných jmen, čísel nebo dat.
Při strukturování může zpracování pomocí modelu odvodit návrhy kategorií nebo polí z nestrukturovaného textu. Ručně psaná poznámka o opravě může obsahovat například datum, objekt a další krok. Aplikace může tyto hodnoty zvýraznit, ale před uložením by je měla zobrazit ke kontrole. Chybně přečtené datum se opravuje snáze, dokud je stále zobrazeno jen jako návrh.
Souhrny pomáhají, když se člověk potřebuje rychle zorientovat v dlouhém textu. Původní zdroj musí zůstat přístupný. Souhrn může vynechat podrobnosti nebo nesprávně vyvážit jejich vzájemné vztahy. Slouží jako pomůcka při čtení, nikoli jako náhrada rozhodné smlouvy, zprávy nebo oznámení.
Užitečné mohou být i pomůcky pro psaní: návrh věcného sdělení, kratší popis nebo strukturovanější poznámka. Dobrý návrh rozhraní dává najevo, že text vznikl automaticky, a usnadňuje jeho úpravy. Odpovědnost za odeslání nesmí zmizet za zdánlivě hotovou formulací.
Nejistota patří do rozhraní
Generativní systémy často vytvářejí plynulé odpovědi, i když nemají dostatek informací. Právě tato zdánlivá jistota může uživatele oklamat. Apple u generativních funkcí mimo jiné doporučuje jasně sdělit, kdy se používá automatizované zpracování, vysvětlit očekávání a omezení, nevzbuzovat dojem přehnané přesnosti a nabídnout možnost kontroly nebo zpětné vazby.
Pouhá poznámka pod čarou „Může obsahovat chyby“ málokdy stačí. Samotná interakce by měla odpovídat riziku. U navrhované kategorie může stačit upravitelný výběr. U několika extrahovaných podrobností smlouvy dává smysl srovnání se zdrojem. Pokud je odpověď založena na nejistých nebo neúplných informacích, aplikace by měla požádat o vysvětlení, nikoli zakrývat mezeru.
Očekávání ovlivňuje i jazyk rozhraní. „Automaticky rozpoznáno“ zní definitivněji než „návrh“. Zvýrazněné hlavní tlačítko může lidi přimět k přijetí výsledku bez kontroly. Neutrální podání, dohledatelný původ a snadná možnost vrátit změnu ukazují, že lidská kontrola je součástí zamýšleného postupu.
Označení je více než symbol automatizace
Ikona jiskry se stala běžným symbolem pro pomocné funkce. Bez textu však nevysvětluje datový tok ani chování. Lidé musí vědět, co se stane, když ji aktivují: Bude zpracován pouze vybraný odstavec nebo celý dokument? Zůstává zpracování v zařízení? Jsou data odesílána externí službě? Bude výsledek uložen? Lze funkci deaktivovat?
Tyto informace patří přímo k místům, kde se uživatel rozhoduje. Krátké a srozumitelné vysvětlení před prvním použitím je užitečnější než čistě právní popis ve vzdáleném dokumentu. U opakovaných akcí by základní pokyny měly zůstat snadno dostupné, aniž by byl každý postup přetížen varováními.
Označení je důležité i u generovaného obsahu. Pokud se shrnutí později objeví vedle ručně psaných poznámek, jeho původ by měl zůstat rozpoznatelný. Jestliže je po lidské kontrole převzato nebo podstatně upraveno, může produkt použít jasně popsaný stav. Cílem není trvale označovat každý řádek, ale budovat důvěru díky dohledatelnému původu.
Jasný tok dat a ochrana dat před integrací
Pomocná funkce může kompletně zpracovávat data na zařízení nebo odesílat požadavky do cloudové služby. Oba způsoby mají výhody i omezení. Modely na zařízení mohou pracovat offline, zkracovat dobu odezvy a uchovávat obsah v zařízení. Jsou omezeny výpočetním výkonem, energií, úložištěm a dostupným modelem. Cloudové modely mohou být výkonnější nebo snadněji aktualizovatelné, ale potřebují připojení k síti a přenos dat do další infrastruktury.
Dokumentace Android Developers tento kompromis popisuje výslovně: zpracování přímo v zařízení podporuje mimo jiné provoz offline a ochranu dat, zatímco cloudová řešení mohou nabídnout větší modely a vyšší výpočetní výkon. Pro každý produkt neexistuje jedna obecně nejlepší architektura. Rozhodující jsou citlivost dat, konkrétní úkol, požadavky na kvalitu, třída zařízení, náklady a očekávané chování bez připojení.
Před integrací cloudu je nutné vyjasnit poskytovatele, účely zpracování, dobu uchovávání, použití dat k trénování, oblast zpracování, zabezpečení přístupu a mazání. Důležitá zůstává zásada minimalizace údajů: pokud pro shrnutí stačí jeden odstavec, neměl by se preventivně přenášet celý soubor. Přímé identifikátory lze odstranit nebo nahradit dříve, než obsah opustí zařízení.
Také lokální zpracování vyžaduje ochranu dat. Stažený model zabírá úložiště a dočasné soubory či protokoly mohou obsahovat citlivý obsah. Vstupy a výsledky musí jít v rámci zamýšleného životního cyklu odstranit. „Lokální“ není zkratkou, která by nahrazovala úplné posouzení bezpečnosti.
Náklady a závislosti jsou součástí rozhodování o produktu
Cloudové modelové služby jsou často účtovány podle použití. Funkce, která v demu generuje málo požadavků, se může v běžném životě výrazně prodražit. Dlouhé vstupy, opakované pokusy, obrázky nebo více uživatelů mění provozní náklady. Limity a kontroly nákladů nesmí později nepředvídatelně zhoršit hlavní proces.
Modely, ceny, zásady a rozhraní se mohou měnit. Poskytovatel může zrušit model nebo aktualizovat jeho chování. Produkt tedy potřebuje strategii verzí, kontroly kvality a případnou změnu. Modelová služba není neměnný balíček, který zůstane po integraci stejný.
Spolehlivý ruční způsob není jen pohodlnou možností. Chrání hlavní úlohu v případě problémů se sítí, výpadků poskytovatele, vyčerpání limitů nebo nedostatečné kvality. Pokud lze poznámku uložit pouze s automatizovanou asistencí, ačkoliv by stačila jednoduchá pole, je architektura zbytečně křehká. Pokud automatická asistence zrychlí první návrh, ale vstup zůstává přímo možný, je závislost lépe ovladatelná.
Kvalitu je třeba kontrolovat ve skutečném kontextu
Model může dosahovat dobrých výsledků v obecných benchmarcích, a přesto být v konkrétní aplikaci nepoužitelný. Odborné termíny, jazyky, krátké záznamy, nekvalitní fotografie a skutečné struktury dokumentů výsledek ovlivňují. Testy proto musí vycházet ze zamýšleného kontextu použití a zahrnovat také vzácné, rozporné nebo záměrně problematické případy.
NIST Risk Management Framework pro systémy založené na modelech popisuje průběžné zacházení s riziky z automatizovaných modelů v oblastech správy, mapování, měření a řízení. Dodatečná publikace NIST o generativních systémech se mimo jiné zabývá konfabulacemi, ochranou dat, integritou informací a závislostmi v hodnotovém řetězci. Pro malý produktový tým z toho lze odvodit praktický postoj: klasifikovat rizika před vývojem, měřit účinky pomocí vhodných případů, definovat odpovědnosti a pokračovat v monitorování chování po uvedení na trh.
Metriky by měly odpovídat cíli produktu. Pro extrakci jsou zajímavější přesnost na pole, nutné korekce a přehlédnuté hodnoty než pouhý počet generovaných návrhů. Při hledání jsou důležité užitečné výsledky a neúspěšné dotazy. V případě souhrnů by se mělo zkontrolovat, zda jsou zachována zásadní prohlášení a neobjevují se žádná nová tvrzení.
Kvalita se může lišit také podle jazyka a obsahu. Pokud lidé používají fotografie s českým textem, zkratky nebo vícejazyčné dokumenty, nelze funkci vydat pouze na základě čistých anglických vzorových sad. Pokud není k dispozici dostatek dat pro spolehlivé vyhodnocení, je poctivější nabídnout užší oblast použití než obecný příslib.
Když je klasická funkce lepší volbou
Mnoho problémů popsaných jako případy použití automatizované pomoci lze spolehlivěji vyřešit osvědčenými prostředky. Seřazený seznam nepotřebuje jazykový model. Přesná čísla měřidel lze snadno najít běžným vyhledáváním. Opakované připomenutí vyžaduje pravidlo, nikoli vygenerované datum. Povinná pole, šablony a rozumné výchozí hodnoty mohou urychlit zadávání, aniž by vnesly nejistotu.
Konvenční řešení je obzvláště silné, když jsou pravidla stabilní, výsledky jasné a důsledky chyb vážné. Testování je jednodušší, často levnější a nezávislé na externím modelu. Modelem podporované zpracování je vhodnější tam, kde variabilita zadání odůvodňuje dodatečné úsilí a ověřitelný návrh nabízí skutečné výhody.
Pomůže jednoduché srovnání: Dá se úkol popsat úplně jako jasné pravidlo? Pak by se toto pravidlo mělo nejprve zkontrolovat. Musí systém získávat význam z různorodých nestrukturovaných materiálů? Pak může být kandidátem zpracování podporované modelem. Má výsledek závažné důsledky a obtížně se ověřuje? Pak může být správným rozhodnutím také jej neautomatizovat.
Zodpovědná pomocná funkce může být nenápadná
Nejlepší pomoc nemusí být nejnápadnější funkcí aplikace. Ve správnou chvíli pomůže s hledáním, strukturou nebo návrhem a pak ustoupí do pozadí. Hlavní postup zůstává srozumitelný i bez automatizace a rozhodnutí zůstává na člověku.
Odpovědná automatizace spojuje konkrétní úkol s minimem dat, viditelnou nejistotou, ověřitelným výsledkem, spolehlivou ruční alternativou a průběžnou kontrolou kvality. Bez toho existuje jen technická možnost, ne hotová produktová funkce.
Zdroje a další čtení
- Apple Pokyny pro lidské rozhraní: Generativní funkce – design, transparentnost, očekávání a uživatelská kontrola.
- Android Developers: Modely v zařízení a v cloudu pro Android – kompromisy mezi zpracováním v zařízení a v cloudu.
- NIST Risk Management Framework pro systémy založené na modelech – rámec pro řízení rizik z důvěryhodných automatizovaných systémů.
- NIST profil pro generativní systémy – specifická rizika a opatření pro generativní systémy.